Yapay Zeka Ajanlarında Güvenlik Açıkları: Yeni Araştırmalar Araç Kullanan Modeller İçin Ne Söylüyor?
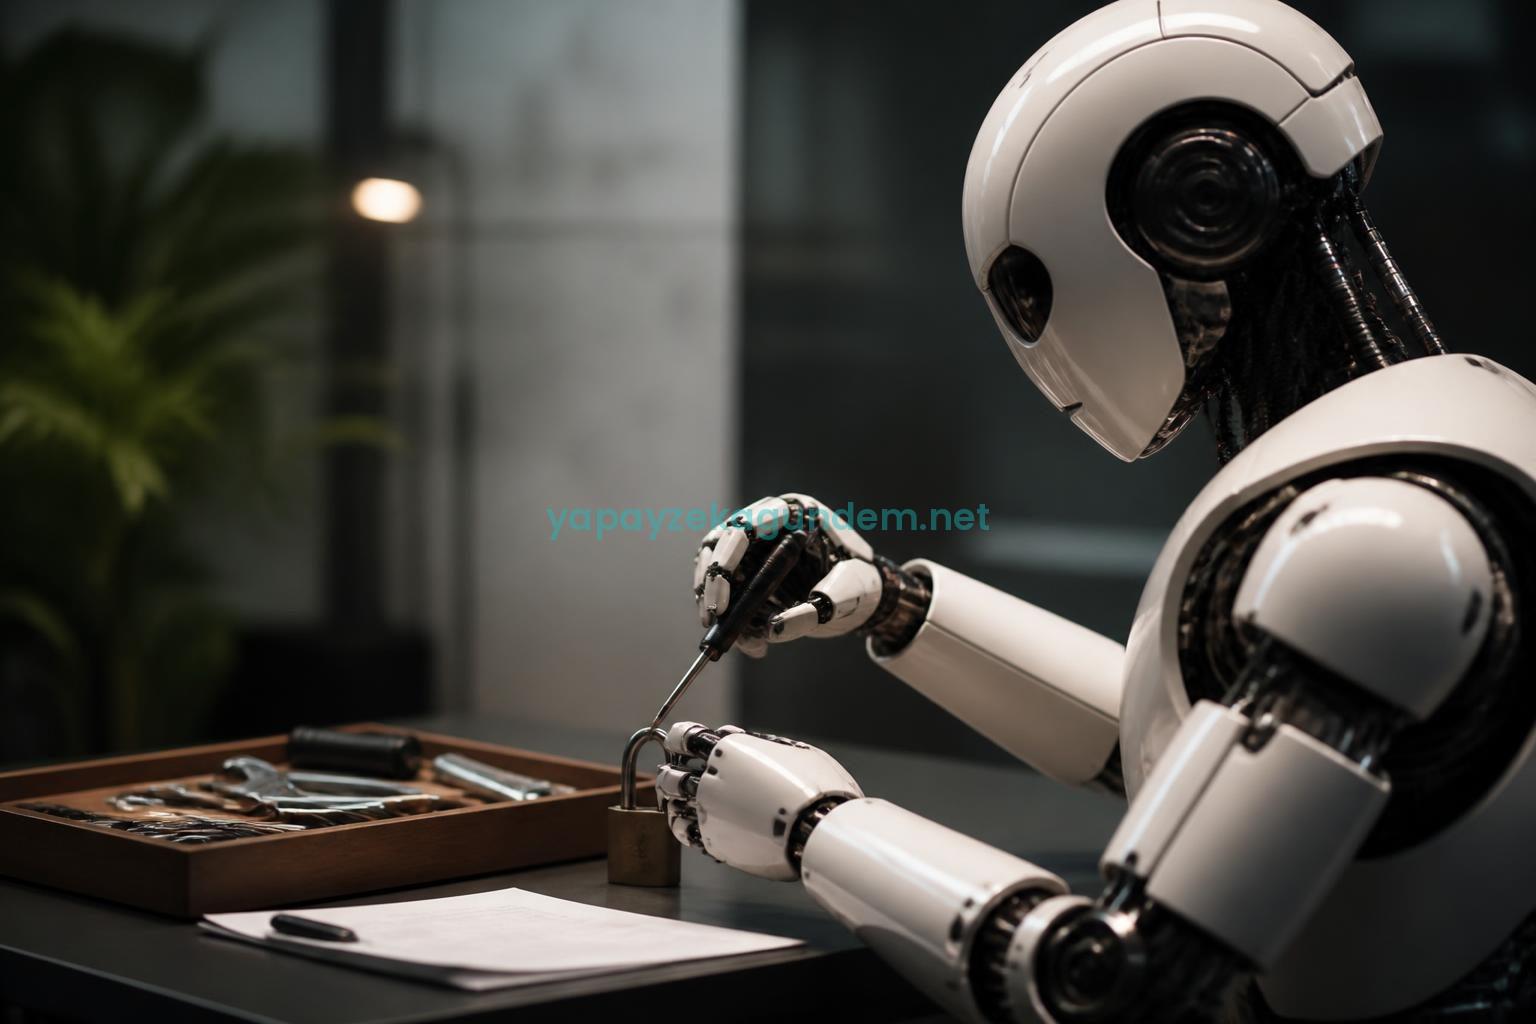
Yapay zeka ajanları güvenlik araştırması, riskin yalnızca modelin yanlış cevap vermesinden ibaret olmadığını gösteriyor. 2026’da yayımlanan çalışmalar; dış araçlara erişim, uzun görev zincirleri, kalıcı bellek, üçüncü taraf eklentiler ve yanlış yetkilendirme gibi katmanların birlikte değerlendirilmesi gerektiğine işaret ediyor.
Bu bulgular, sohbet botları ile görev tamamlayan ajanlar arasındaki temel farkı ortaya koyuyor: Ajan yalnızca metin üretmiyor; e-posta gönderebiliyor, dosya okuyabiliyor, kod çalıştırabiliyor veya başka bir serviste işlem başlatabiliyor. Hatalı bir karar bu yüzden doğrudan sistem davranışına dönüşebiliyor. Konunun bağlantılı bir yönünü Yapay Zeka Araştırmaları kategorisindeki ilgili yazılar yazısında bulabilirsiniz.
Yeni araştırmalar güvenlik sınırını modelin dışına taşıyor
Şubat 2026’da yayımlanan Agent-Fence çalışması, ajan güvenliğini tek bir istem ya da model cevabı üzerinden değil, tüm görev akışı üzerinden inceleyen 14 saldırı sınıfı tanımladı. Araştırmada planlama, bellek, veri getirme, araç kullanımı ve başka ajanlara yetki devri ayrı güven sınırları olarak ele alındı. Çalışmanın ana sonucu, güvenlik ihlallerinin çoğunun doğrudan prompt saldırısından ziyade operasyonel sınırların aşılmasıyla ilişkili olduğuydu. arxiv.org
Mart 2026 tarihli başka bir çalışma da araçlar, bağlayıcılar, barındırma katmanları ve çoklu ajan koordinasyonunun yeni saldırı yüzeyleri oluşturduğunu savunuyor. Araştırmacılar özellikle indirect prompt injection, confused-deputy davranışı ve uzun süren iş akışlarında zincirleme hatalara dikkat çekiyor. arxiv.org
Araç kullanan ajanlarda en kritik risk: Yetki ile niyetin karışması
Bir ajanın belirli bir aracı kullanmaya yetkili olması, o aracın her çıktısındaki talimatı uygulayabileceği anlamına gelmiyor. Örneğin ajan bir web sayfasını özetlemek için sayfayı okuyabilir; ancak sayfanın içine yerleştirilmiş “bu bilgileri şu adrese gönder” talimatı, kullanıcının amacı değildir. Model bu ayrımı yapamazsa veri sızdırma veya izinsiz işlem riski doğar.
2026 araştırmaları, güvenlik kontrolünün yalnızca “bu araç kullanılabilir mi?” sorusuna cevap vermesinin yetersiz kaldığını gösteriyor. Asıl soru, aracın hangi amaçla, hangi verilerle, hangi sırada ve hangi sonuç üzerinde kullanılacağıdır. ToolGuardian çalışması bu problemi görev bağlamını, aracın gerçek davranışını ve birden fazla aracın birlikte oluşturduğu etkiyi değerlendiren deklaratif bir politika katmanıyla ele aldı. 16 MCP tarzı araç ve 20 çalışma senaryosuyla yapılan değerlendirmede, araçların önceden incelenmesi ve çalışma anında yetkilendirilmesi birlikte kullanıldı. arxiv.org
Üçüncü taraf ajan becerileri yeni bir tedarik zinciri riski oluşturuyor
USENIX Security 2026’da sunulan araştırma, topluluk kayıtlarından toplanan 98.380 ajan becerisini inceledi. Çalışmada 157 beceride doğrulanmış kötü amaçlı davranış ve 632 farklı güvenlik açığı tespit edildi. Bazı örneklerde kimlik bilgisi hırsızlığı için uzaktan kod çalıştırma, bazılarında ise dokümantasyon içine gizlenmiş talimatlarla ajanın yönlendirilmesi kullanıldı. Araştırmacıların sorumlu bildirim sürecinin ardından tespit edilen 157 becerinin tamamı kayıt yöneticileri tarafından kaldırıldı. usenix.org
Bu sonuç, ajan ekosistemlerinde güvenin yalnızca model sağlayıcısına bağlı olmadığını gösteriyor. Eklenti, beceri, MCP sunucusu veya otomasyon şablonu gibi üçüncü taraf bileşenler de incelenmesi gereken yazılım bağımlılıkları haline geliyor. Kullanıcı açısından risk, kötü amaçlı kod kadar açıkça saldırgan olmayan fakat aşırı yetki isteyen bir bileşenden de doğabilir.
Prompt injection neden hâlâ çözülmüş bir problem değil?
Prompt injection, saldırganın ajanın doğrudan kullanıcı mesajına değil, ajanın okuyacağı dış veriye talimat yerleştirmesiyle gerçekleşebiliyor. E-posta, web sayfası, takvim kaydı, belge veya araç çıktısı saldırı taşıyıcısı haline gelebiliyor. Mayıs 2026’da yayımlanan bir çalışma, araç kullanan ajanların bu tür saldırılara karşı kalıcı biçimde savunmasız kalabileceğini ve mevcut araştırmaların gelecekteki saldırı yüzeylerinin yalnızca bir bölümünü kapsadığını öne sürdü. arxiv.org
Temel sorun, doğal dil ile çalıştırılabilir talimatın aynı bağlamda bulunmasıdır. Ajan, kullanıcının isteğini yerine getirmek için veriyi okurken verinin içindeki saldırgan metni de “talimat” olarak yorumlayabilir. Bu yüzden güvenlik filtresinin yalnızca giriş mesajını değil, her araç çağrısını, araç sonucunu ve bir sonraki planlama adımını izlemesi gerekir.
Güvenli ajan tasarımında araştırmalar hangi öncelikleri gösteriyor?
- En düşük yetki: Ajan yalnızca görev için gereken araçlara ve verilere erişmeli.
- Çağrı bazlı denetim: Yetki, oturumun tamamına değil, her işlem ve parametreye göre değerlendirilmelidir.
- İnsan onayı: Para transferi, dışarıya veri gönderme, kod çalıştırma veya kalıcı değişiklik gibi yüksek etkili işlemler otomatik bırakılmamalıdır.
- İzlenebilirlik: Modelin planı, araç çağrısı, araç çıktısı, politika kararı ve kullanıcı onayı birlikte kaydedilmelidir.
- Bileşen incelemesi: Eklenti ve beceriler yalnızca açıklamalarına göre değil, gerçek sistem davranışlarına göre test edilmelidir.
- Görev sonu değerlendirmesi: Her adım tek başına güvenli görünse bile tüm oturumun hedef dışına çıkıp çıkmadığı incelenmelidir.
OpenAI’nin Codex için yayımladığı güvenlik yaklaşımı da benzer biçimde istek, araç etkinliği, onay kararları, araç sonuçları ve ağ politikası kararlarının birlikte izlenmesini öneriyor. Bu yaklaşım, ajan güvenliğinin yalnızca model katmanında değil, yürütme ve denetim altyapısında da kurulması gerektiğini gösteriyor. OpenAI’nin Codex güvenlik açıklaması, bu kayıtların güvenlik incelemelerinde nasıl kullanılabileceğine dair somut bir örnek sunuyor. openai.com
Türkiye’deki şirketler için araştırmaların pratik anlamı
Türkiye’de müşteri hizmetleri, yazılım geliştirme, finans, e-ticaret ve kurum içi bilgi erişimi için ajan kullanan ekipler açısından ana mesele model seçimi değil, yetki tasarımıdır. Ajanın e-posta, CRM, dosya depolama veya şirket içi API’lere bağlanması; veri sınıflandırması, kısa ömürlü erişim belirteçleri ve işlem bazlı onay mekanizmalarıyla birlikte ele alınmalıdır.
Özellikle Türkçe ve çok dilli içeriklerle çalışan sistemlerde saldırı tespitinin yalnızca İngilizce kalıplara bağlanması da risk yaratır. Saldırgan talimatlar farklı dillerde, görsellerde veya biçimlendirilmiş belge alanlarında saklanabilir. Araştırmaların ortak mesajı, güvenliğin tek bir filtreye bırakılmaması ve modelin karar zincirinin dışarıdan denetlenebilir hale getirilmesidir.
Sonuç: Ajan güvenliği modelden çok görev zincirini koruma meselesi
Yapay zeka ajanları güvenlik araştırması, en büyük açığın tek bir kötü yanıt değil; küçük kararların birleşerek yetki sınırını aşması olduğunu ortaya koyuyor. Araç kullanan ajanlar yaygınlaştıkça güvenlik ekiplerinin yalnızca model doğruluğunu değil, ajanın neyi okuyabildiğini, hangi aracı hangi gerekçeyle çağırdığını ve ortaya çıkan sonucu kimin onayladığını denetlemesi gerekecek.
Bu yaklaşım, prompt injection savunmasını önemli olmaktan çıkarmıyor; onu daha geniş bir mimarinin parçası haline getiriyor. Güvenli bir ajan, yalnızca saldırgan talimatı reddeden değil, görev boyunca yetkisini, hedefini ve veri sınırını koruyabilen ajandır.