Yapay Zeka Modellerinde İç Temsillerin Haritalanması: Mekanik Yorumlanabilirlik Araştırmaları Ne Gösteriyor?
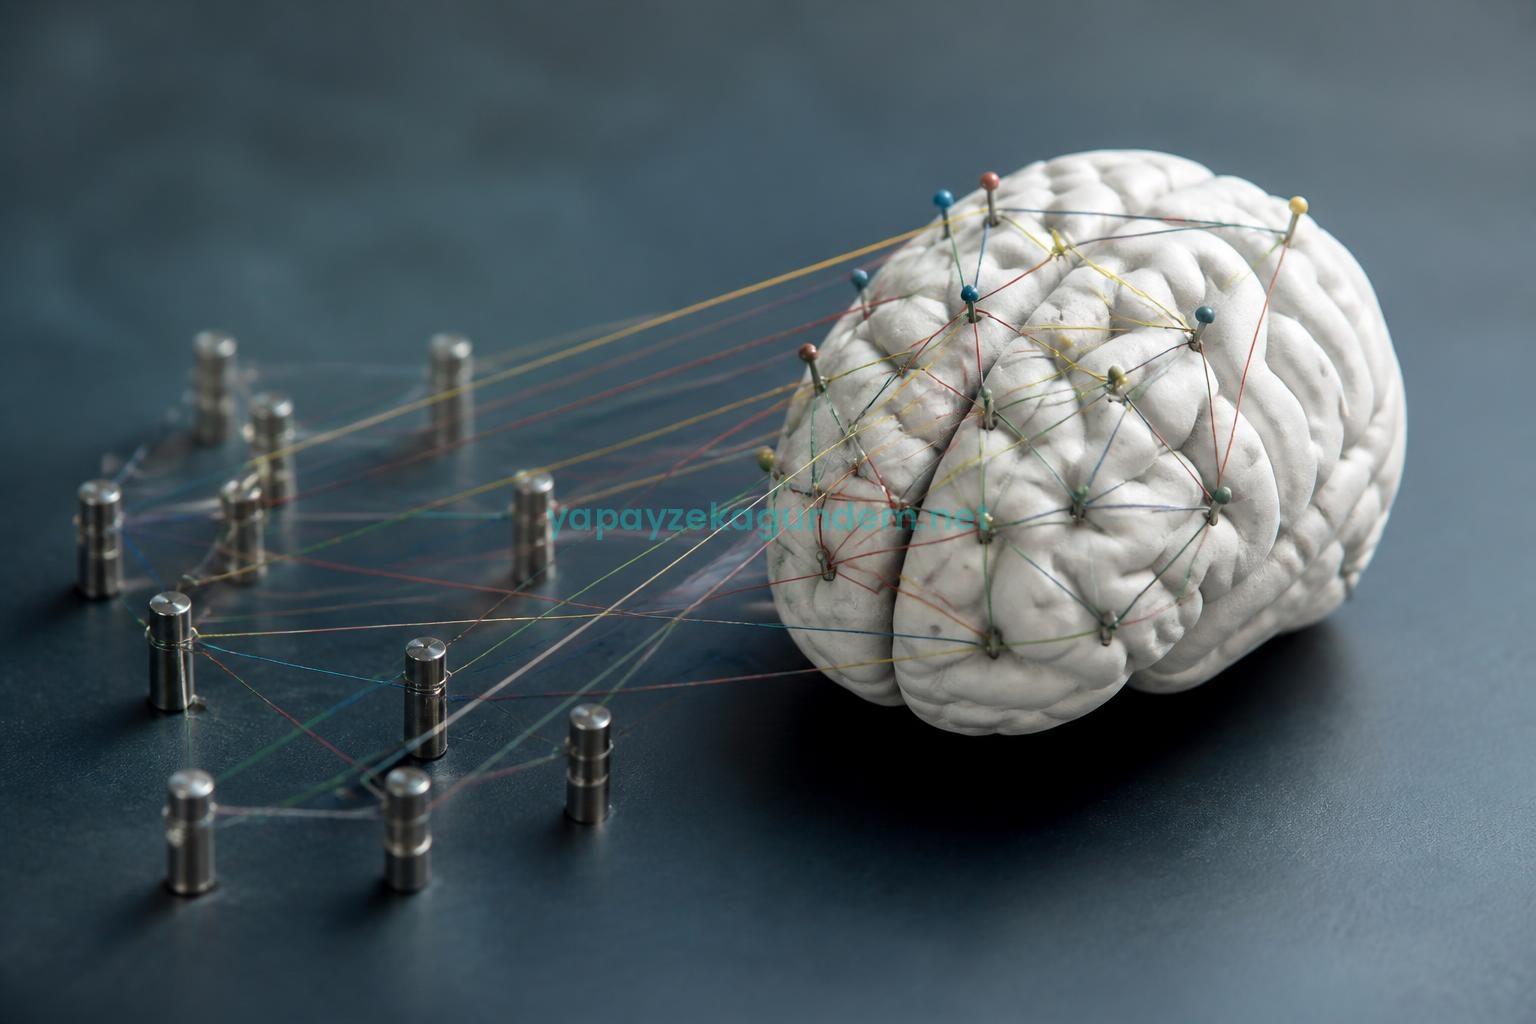
Yapay zeka modellerinde mekanik yorumlanabilirlik araştırmaları, bir modelin yalnızca hangi yanıtı verdiğini değil, o yanıta ulaşırken iç hesaplama alanında neler yaptığını anlamaya çalışıyor. Eylül 2026 itibarıyla alan; özellik haritalama, seyrek otomatik kodlayıcılar, devre izleme, katman bazlı yerelleştirme ve nedensel müdahene gibi yöntemleri aynı hedef etrafında birleştiriyor: model davranışını insanın test edebileceği mekanizmalara ayırmak.
Son çalışmaların ortak sonucu net: Araştırmacılar artık bazı kavramların nerede ve hangi bağlantılarla temsil edildiğine dair daha somut hipotezler kurabiliyor. Ancak bu bulgular, büyük bir modelin tüm karar sürecinin çözüldüğü anlamına gelmiyor. İlgili ayrıntılar için Yapay Zeka Araştırmaları kategorisindeki ilgili yazılar içeriği de değerlendirilebilir.
İç temsil haritalama araştırmaları neyi değiştirdi?
Bir dil modelinin aktivasyonları, insanın doğrudan okuyabileceği kavramlar halinde düzenlenmez. Aynı nöron birden fazla özellikle ilişkili olabilir; bir kavram da tek bir noktada değil, farklı katmanlara ve bileşenlere dağıtılmış biçimde temsil edilebilir. Bu sorun, mekanik yorumlanabilirliğin temel teknik engellerinden biri olan süperpozisyon ile ilişkilendiriliyor.
Araştırmacılar bu yoğun aktivasyon alanını daha anlaşılır parçalara ayırmak için seyrek otomatik kodlayıcılar kullanıyor. Bu modeller, çok boyutlu aktivasyonları daha seyrek özelliklere dönüştürerek belirli örüntülerin hangi girdilerde ortaya çıktığını incelemeye yardımcı oluyor. Anthropic’in önceki çalışmalarında bu yaklaşım, Claude 3 Sonnet içinde milyonlarca özellik bulunduğuna ilişkin analizlerin temelini oluşturdu. Şirketin teknik açıklamasında ölçek büyüdükçe özellikleri çıkarmanın yalnızca araştırma değil, ciddi bir veri ve mühendislik problemi olduğu belirtiliyor.
Yapay zeka modellerinde mekanik yorumlanabilirlik için öne çıkan yöntemler
| Yöntem | İncelediği soru | Başlıca sınırı |
|---|---|---|
| Seyrek otomatik kodlayıcılar | Aktivasyonlarda hangi anlaşılabilir özellikler bulunuyor? | Bulunan özelliklerin gerçekten tek bir kavrama karşılık gelip gelmediği her zaman kesin değil. |
| Özellik yönlendirme | Belirli bir iç özelliği artırmak veya azaltmak çıktıyı değiştiriyor mu? | Müdahale, hedeflenmeyen yetenekleri ve davranışları da etkileyebilir. |
| Devre ve atıf grafikleri | Özellikler model çıktısına hangi bilgi akışıyla katkı sağlıyor? | Grafikler çoğu zaman hesaplamanın yalnızca bir bölümünü temsil eder. |
| Aktivasyon yaması | Bir katmandaki temsili değiştirmek sonucu nedensel olarak değiştiriyor mu? | Sonuç, seçilen karşılaştırma örneklerine ve müdahale noktasına duyarlıdır. |
Bu yöntemler birbirinin alternatifi olmaktan çok farklı kanıt türleri sağlıyor. Bir özellik gözlemlenebilir bir kavramla eşleşebilir; fakat o özelliğin modelin kararında gerçekten rol oynadığını göstermek için aktivasyonu değiştirmek ve çıktıyı ölçmek gerekiyor. Bu ayrım, yalnızca “hangi örneklerde etkinleşti?” sorusuyla “çıktıyı nedensel olarak etkiliyor mu?” sorusu arasındaki farkı ortaya koyuyor.
Devre izleme, özelliklerden karar akışına geçiş sağlıyor
İç temsilleri tek tek özellikler halinde bulmak önemli bir başlangıç. Fakat model davranışını anlamak için bu özelliklerin hangi sırayla ve hangi bağlantılar üzerinden birlikte çalıştığını da görmek gerekiyor. Anthropic’in 2025’te açık kaynak olarak yayımladığı devre izleme araçları, desteklenen modellerde atıf grafikleri oluşturarak özellikler arasındaki bilgi akışını görselleştirmeyi amaçlıyor. Araştırmacılar bu grafiklerdeki bazı değerleri değiştirerek belirli hipotezleri test edebiliyor. Açık kaynak devre izleme duyurusuna göre araçlar, çok adımlı akıl yürütme ve çok dilli temsiller gibi davranışların incelenmesinde kullanıldı.
Bu yaklaşım, modelin “düşünce zincirini” eksiksiz biçimde okuduğu iddiasını taşımıyor. Daha doğru tanım, belirli bir çıktı için hesaplamanın bazı ara yollarını yaklaşık olarak izlemek. Özellikle çok sayıda paralel devrenin aynı çıktıya katkı verdiği durumlarda tek bir grafik, modelin bütün iç sürecini açıklamayabilir.
Yeni çalışmalar iç temsillerin katmanlar boyunca nasıl oluştuğunu inceliyor
6 Temmuz 2026’da Anthropic, dil modellerinde “global workspace” olarak adlandırdığı bir iç çalışma alanına ilişkin araştırmasını yayımladı. Çalışma, modelin çıktıya doğrudan yansımayan bazı iç içerikleri ortak bir temsil alanında tutabildiğini inceleyen bir yaklaşım sunuyor. Bu tür araştırmaların önemi, yalnızca kavramların bulunduğu yeri değil, farklı hesaplamaların hangi ara alanda bir araya geldiğini araştırması.
Benzer bir çizgide, Transformer Circuits araştırmasında katmanlar ve belirli token konumları boyunca ara temsilleri okumaya yarayan bir “J-lens” yaklaşımı ele alınıyor. Çalışmadaki aritmetik örneklerde ara sonuçların, gerekli girdiler erişilebilir hale geldikçe farklı katmanlarda ortaya çıktığı ve aktivasyon yamasıyla bu ara değerlerin nedensel etkisinin sınandığı aktarılıyor. Bu, araştırmacılara bir temsilin yalnızca var olup olmadığını değil, hesaplamanın hangi aşamasında kullanıldığını da sorma imkânı veriyor.
Yöntemlerin güçlü ve zayıf tarafları nasıl ayrılıyor?
Seyrek özellik çıkarımı, büyük aktivasyon alanlarını insanın inceleyebileceği bir sözlüğe dönüştürmede güçlü. Fakat özellik etiketinin insan tarafından verilmesi, açıklamanın bir bölümünü yorumlayıcıya bırakıyor.
Devre izleme, tek bir kavramdan daha fazlasını göstererek bilgi akışını incelemeye yaklaşıyor. Buna karşılık grafiklerin tamamı doğrudan gözlenmiş bir “program” değil; seçilen model, katman ve analiz yöntemiyle oluşturulan bir açıklama çerçevesi.
Nedensel müdahale, en kritik doğrulama araçlarından biri. Bir iç değeri değiştirince model çıktısı da beklenen yönde değişiyorsa, açıklama daha güçlü hale geliyor. Yine de müdahalenin gerçek kullanım koşullarındaki davranışı temsil edip etmediği ayrıca test edilmeli. Anthropic’in özellik yönlendirme deneylerinde, belirli davranışların hedeflenebildiği ancak müdahale şiddeti yükseldiğinde genel yeteneklerde bozulma görülebildiği raporlandı. Bu deneylerin sonuçları, iç özellikleri kontrol etmenin otomatik olarak güvenli ve sınırlı bir değişiklik anlamına gelmediğini gösteriyor.
Bu araştırmalar yapay zeka güvenliği için ne ifade ediyor?
İç temsillerin haritalanması, standart davranış testlerinin yakalayamadığı bazı riskleri araştırmak için ek bir mercek sunabilir. Örneğin modelin bir kavramı temsil edip etmediği, belirli bir bilgiyi ne zaman kullandığı veya zararlı bir davranışa giden bilgi akışının hangi bileşenlerden geçtiği incelenebilir.
Ancak mekanik yorumlanabilirlik, tek başına güvenlik sertifikası değildir. Araştırmacılar bir özelliği bulsa bile bunun modelin bütün bağlamlarda aynı işleve sahip olduğunu varsayamaz. Temsil dağılımı, model sürümü, istem biçimi ve görev türü değiştikçe açıklamanın geçerlilik alanı da değişebilir. Bu nedenle en güvenilir yaklaşım, iç analizleri davranış testleri, kırmızı takım çalışmaları ve bağımsız değerlendirmelerle birlikte kullanmak.
Alan için en önemli ilerleme, “modelin içinde ne var?” sorusundan “hangi iç yapı hangi çıktıyı hangi koşulda etkiliyor?” sorusuna geçiş yapılması. Araştırmacılar bu geçişi sağlayacak araçları geliştiriyor; fakat büyük modellerde tam ve eksiksiz bir iç harita oluşturulmuş değil.
Kısa karar: Yapay zeka modellerinde mekanik yorumlanabilirlik, iç temsilleri görünür ve sınanabilir hale getirmede önemli mesafe aldı. Bugünkü sonuçlar, model davranışının bazı parçalarını açıklamaya ve müdahale etmeye izin veriyor; tüm karar sürecini çözmeye değil.